MediaPipe Pose 33ランドマーク完全ガイド|番号一覧と、公式に載っていない実測の注意点
投稿日: 2026年5月2日(最終更新日: 2026年10月3日)
対象読者: MediaPipe Pose Landmarker を使う開発者 / ポーズ推定を実装したい方
この記事はこんな方向け:
- 33個のランドマークの番号と部位を確認したい方
- lite / full / heavy のどれを使えばいいか迷っている方
visibilityが取れない、奥行きzがおかしい、人物が検出されない、で困っている方
はじめに
自作の3Dデッサン人形アプリ PoseMirror では、写真1枚から MediaPipe Pose Landmarker で33点を取り、3Dモデルの姿勢に変換しています。
作っている途中で何度も詰まったのは、番号の覚え違いよりも、公式ドキュメントに書かれていない挙動のほうでした。visibility を使うつもりで書いたコードが、実は毎回 undefined を読んでいた。写真ではまっすぐ伸びている腕が、3Dモデルでは肘で曲がる。顔が写っていない写真だと、人物そのものが見つからない。
公式ドキュメントにある情報(33点の一覧、出力の意味、3つのモデル)はそのまま整理し、載っていない挙動は Unsplash の人物写真120枚で測って図にしました。
33ランドマーク一覧(公式)
全身の配置図
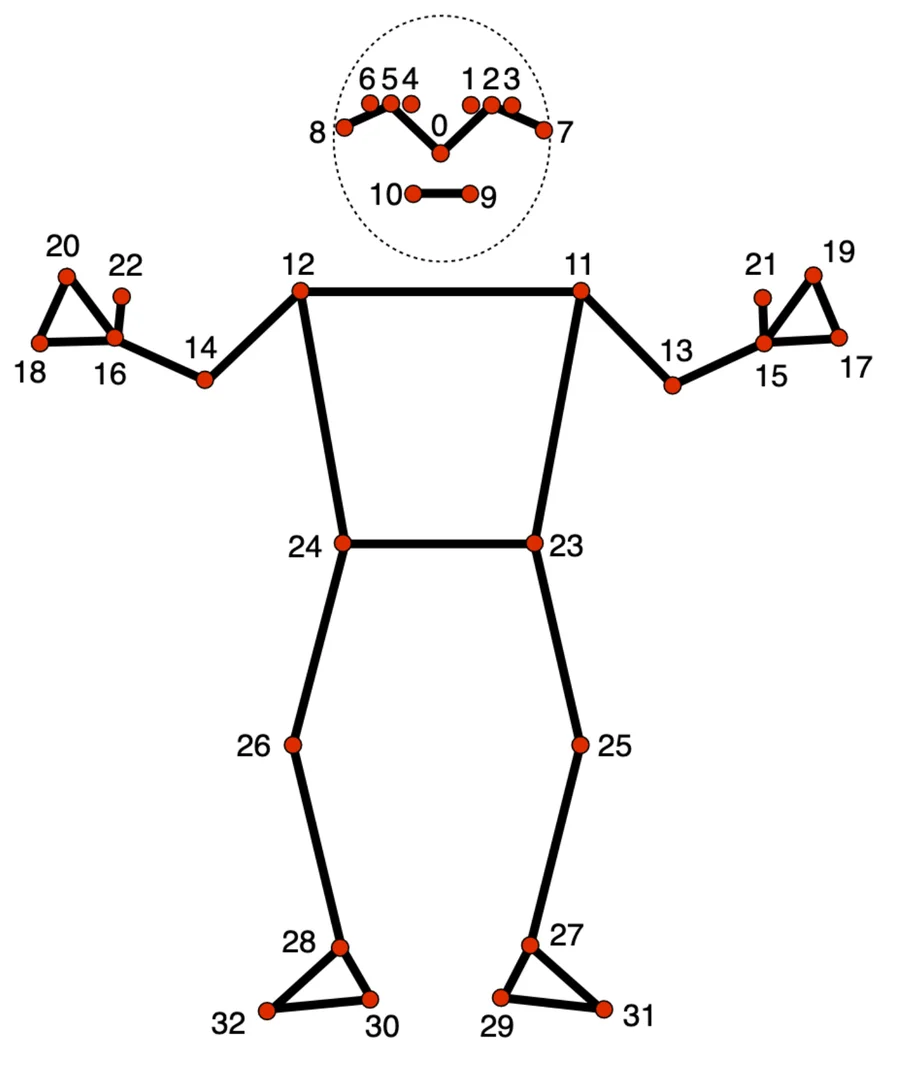
出典:Pose landmark detection guide(Google, CC BY 4.0)
手は手首・小指・人差し指・親指の4点で、手首と小指・人差し指が三角形を作ります。
顔・頭部(0〜10)
| 番号 | 公式名 | 部位 |
|---|---|---|
| 0 | nose | 鼻 |
| 1 | left eye (inner) | 左目(目頭) |
| 2 | left eye | 左目(中心) |
| 3 | left eye (outer) | 左目(目尻) |
| 4 | right eye (inner) | 右目(目頭) |
| 5 | right eye | 右目(中心) |
| 6 | right eye (outer) | 右目(目尻) |
| 7 | left ear | 左耳 |
| 8 | right ear | 右耳 |
| 9 | mouth (left) | 口の左端 |
| 10 | mouth (right) | 口の右端 |
上半身(11〜22)
| 番号 | 公式名 | 部位 |
|---|---|---|
| 11 | left shoulder | 左肩 |
| 12 | right shoulder | 右肩 |
| 13 | left elbow | 左肘 |
| 14 | right elbow | 右肘 |
| 15 | left wrist | 左手首 |
| 16 | right wrist | 右手首 |
| 17 | left pinky | 左手の小指の付け根 |
| 18 | right pinky | 右手の小指の付け根 |
| 19 | left index | 左手の人差し指の付け根 |
| 20 | right index | 右手の人差し指の付け根 |
| 21 | left thumb | 左手の親指 |
| 22 | right thumb | 右手の親指 |
17〜22 は手の向きが分かる程度の3点です。指の曲げ伸ばしまで取りたいなら、手専用の Hand Landmarker(片手21点)を併用します。
下半身(23〜32)
| 番号 | 公式名 | 部位 |
|---|---|---|
| 23 | left hip | 左腰 |
| 24 | right hip | 右腰 |
| 25 | left knee | 左膝 |
| 26 | right knee | 右膝 |
| 27 | left ankle | 左足首 |
| 28 | right ankle | 右足首 |
| 29 | left heel | 左かかと |
| 30 | right heel | 右かかと |
| 31 | left foot index | 左つま先 |
| 32 | right foot index | 右つま先 |
出力の中身(公式)
Pose Landmarker は1人につき2種類の座標を返します。
| 出力 | x, y | z | 原点・単位 |
|---|---|---|---|
landmarks |
画像の幅・高さで割った 0〜1 の値 | 奥行き。値が小さいほどカメラに近い。大きさの目安は x とほぼ同じ | z だけ左右の腰の中点が原点 |
worldLandmarks |
実空間の3D座標 | 同左 | 左右の腰の中点が原点、単位はメートル |
各点には visibility(その点が画像内で見えている=画面内にあって隠れていない確率)が付きます。公式ドキュメントには、検出の確信度を表す presence も出力として書かれています。
主な設定項目は次のとおりです。
| 設定(Web版の名前) | 既定値 | 意味 |
|---|---|---|
runningMode |
IMAGE |
IMAGE / VIDEO / LIVE_STREAM |
numPoses |
1 | 検出する最大人数 |
minPoseDetectionConfidence |
0.5 | 人物検出のしきい値 |
minPosePresenceConfidence |
0.5 | 姿勢が存在するとみなすしきい値 |
minTrackingConfidence |
0.5 | 動画で前のフレームから追跡を続けるしきい値 |
outputSegmentationMasks |
false | 人物の切り抜きマスクも出すか |
処理は2段構成です。まず人物検出器が「腰の中点」「全身を囲む円の半径」「肩と腰を結ぶ線の傾き」を推定して人物の位置を決め、その範囲を骨格推定モデルに渡します。動画では、検出器が動くのは最初のフレームと人物を見失ったときだけで、それ以外のフレームは前のフレームの骨格から範囲を決めます。
コード例(Tasks API・ブラウザ)
import { PoseLandmarker, FilesetResolver } from "https://cdn.jsdelivr.net/npm/@mediapipe/tasks-vision@1.0.1";

const vision = await FilesetResolver.forVisionTasks(
  "https://cdn.jsdelivr.net/npm/@mediapipe/tasks-vision@1.0.1/wasm"
);
const poseLandmarker = await PoseLandmarker.createFromOptions(vision, {
  baseOptions: {
    modelAssetPath:
      "https://storage.googleapis.com/mediapipe-models/pose_landmarker/pose_landmarker_heavy/float16/1/pose_landmarker_heavy.task",
    delegate: "GPU",
  },
  runningMode: "IMAGE",
  numPoses: 1,
});

const result = poseLandmarker.detect(imageElement);
const lm = result.landmarks[0];        // 画像基準の33点
const world = result.worldLandmarks[0]; // メートル単位の33点
if (lm) {
  const leftShoulder = lm[11]; // { x, y, z, visibility }
  console.log(leftShoulder.x, leftShoulder.y, leftShoulder.visibility);
}
旧版の @mediapipe/pose(pose.onResults(...) で受け取る書き方)の記事も多く出回っていますが、新しく書くなら上の Tasks API を使います。
3つのモデル:lite / full / heavy(公式)
| モデル | ファイルサイズ※ | 精度 PCK@0.2(ヨガ / ダンス / HIIT) | 処理時間 Pixel 3 / MacBook Pro 2017 |
|---|---|---|---|
| lite | 5.8MB | 90.2% / 92.5% / 93.5% | 20ms / 25ms |
| full | 9.4MB | 95.5% / 96.3% / 95.7% | 25ms / 27ms |
| heavy | 30.7MB | 96.4% / 97.2% / 97.5% | 53ms / 38ms |
※ファイルサイズは公式に記載がなく、配布URLの .task を2026年10月に実測した値です。精度と処理時間は旧 MediaPipe Pose のドキュメントの値です。
入力サイズは3つとも同じで、人物検出器が 224×224、骨格推定が 256×256 です。
公式に載っていない話(実測)
以下は、Unsplash で集めた人物写真120枚(ダンス・ヨガ・スポーツ・座り・しゃがみ等)を3つのモデルに通して測った結果です。
- 計測環境: Windows 11 / Chromium(Playwright)/ GeForce RTX 4070 / Core i7-13700F
- ライブラリ:
@mediapipe/tasks-vision1.0.1(visibilityの項のみ複数の版を比較)
1. 古い版では visibility が出力されない
visibility を使うつもりでコードを書いても、ブラウザ版の古い版を読んでいると値は undefined です。heavy モデルで、版ごとに出力のキーを調べました。
@mediapipe/tasks-vision の版 |
1点あたりのキー |
|---|---|
| 0.10.0 〜 0.10.10 | x, y, z のみ |
| 0.10.11 〜 1.0.1 | x, y, z, visibility |
公式ドキュメントにある presence は、1.0.1 でも各点には付いていませんでした。
lm.visibility > 0.5 のような判定は、undefined > 0.5 が false になるため、古い版では全関節が「見えていない」扱いになります。逆に lm.visibility ?? 1 と既定値を補うコードなら、全関節が「見えている」扱いになります。どちらでもエラーは出ないので、気づきにくい不具合です。
2. lite と heavy の差は「取れる骨格」に出る
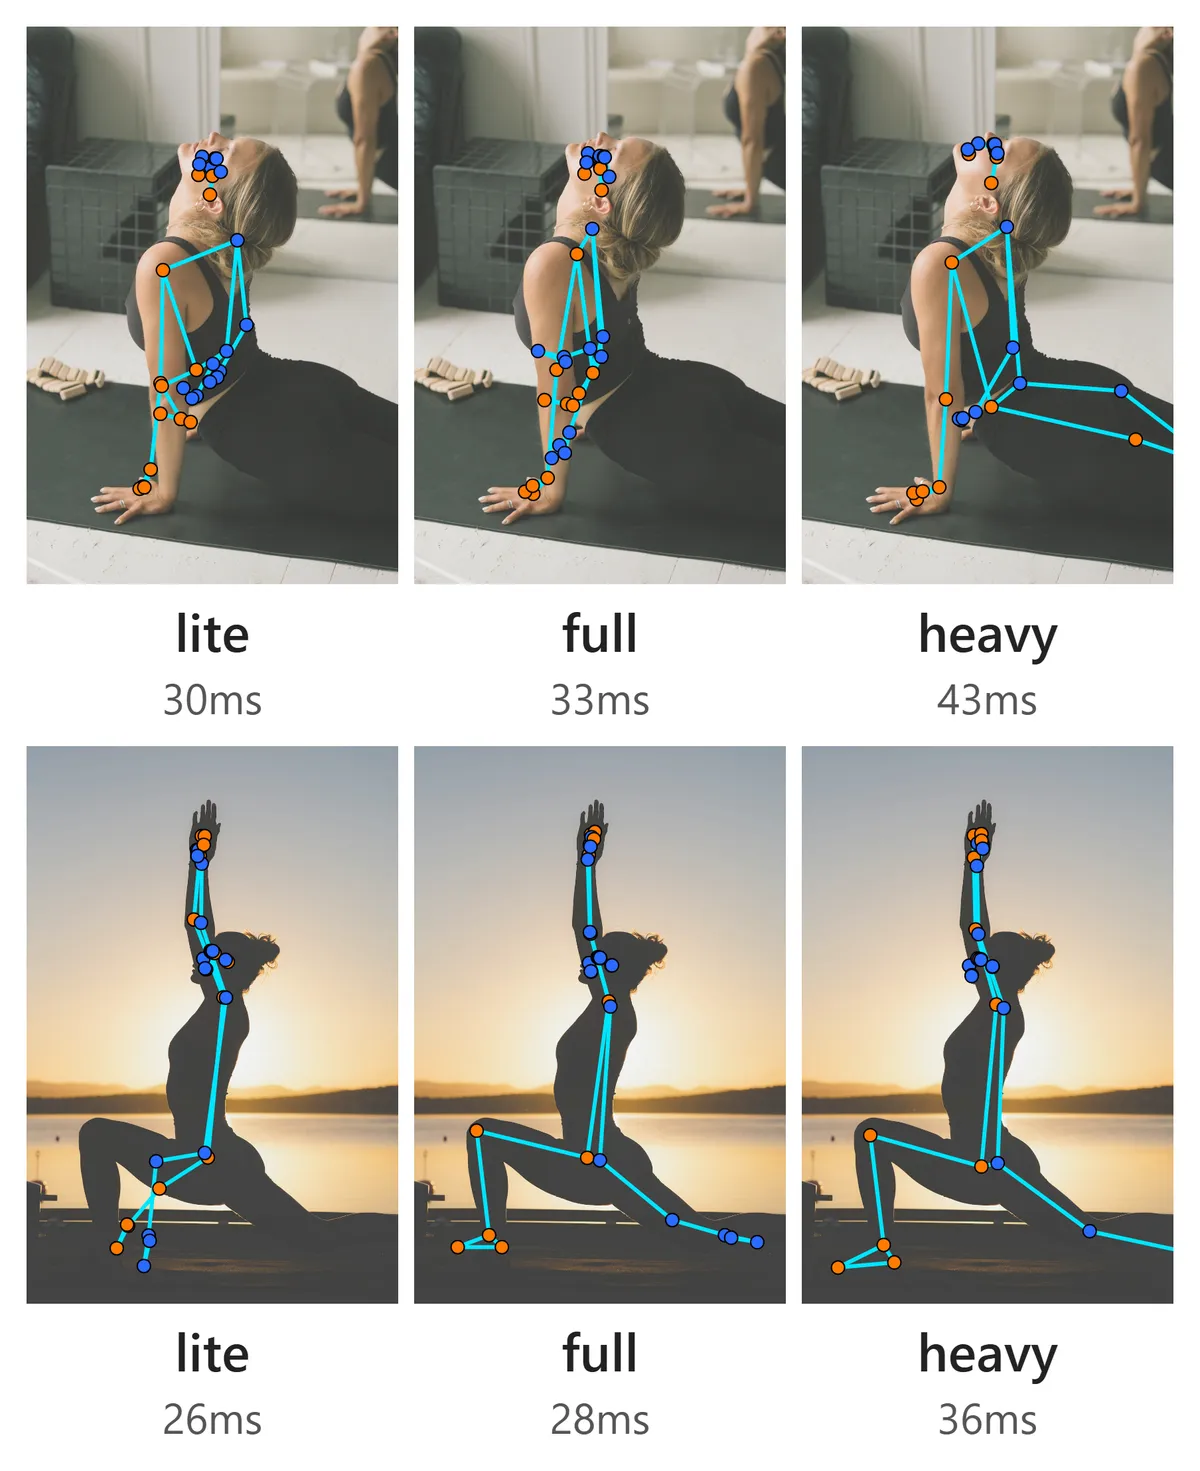
1段目のヨガの写真では、lite と full が脚を見失い、骨格が腕の上に潰れています。脚まで取れたのは heavy だけです。2段目の逆光のランジでは、lite だけ脚が崩れました。
120枚全体の数字は次のとおりです。
| モデル | 検出できた枚数 | 処理時間(中央値) |
|---|---|---|
| lite | 88 / 120 | 31ms |
| full | 85 / 120 | 33ms |
| heavy | 90 / 120 | 42ms |
検出できた枚数はほとんど変わりません。差が出るのは、検出できた写真で骨格が正しく取れているかどうかのほうです。図のように、lite は「人物は見つけたが脚の位置が違う」という外れ方をします。
PoseMirror は写真1枚を解析するアプリで、動画のように毎秒何十枚も処理する必要がありません。そのため、10ms の差よりも骨格の正しさを取って heavy を使っています。ただし、ファイルサイズは lite の約5倍の 30.7MB あり、初回の読み込みはその分遅くなります。
3. CPU と GPU で、検出できる写真が変わる
baseOptions.delegate を "CPU" にするか "GPU" にするかで、検出できる写真そのものが変わりました。
| モデル | CPU でだけ検出できた | GPU でだけ検出できた |
|---|---|---|
| lite | 10枚 | 4枚 |
| full | 10枚 | 5枚 |
| heavy | 7枚 | 7枚 |
heavy は、検出できた枚数こそ CPU・GPU とも90枚で同じですが、そのうち7枚ずつは違う写真でした。GPU で2回測ると、検出の可否は120枚すべてで一致しました。同じ環境なら毎回同じ結果になるので、偶然のぶれではなく、CPU と GPU の計算の違いで分かれていると考えています(原因までは確かめていません)。
手元で検出できた写真が利用者の環境では検出できない、ということが起こり得ます。不具合の報告を再現するときは、delegate をそろえてから確かめてください。
4. worldLandmarks の奥行きをそのまま使うと、肘がずれる
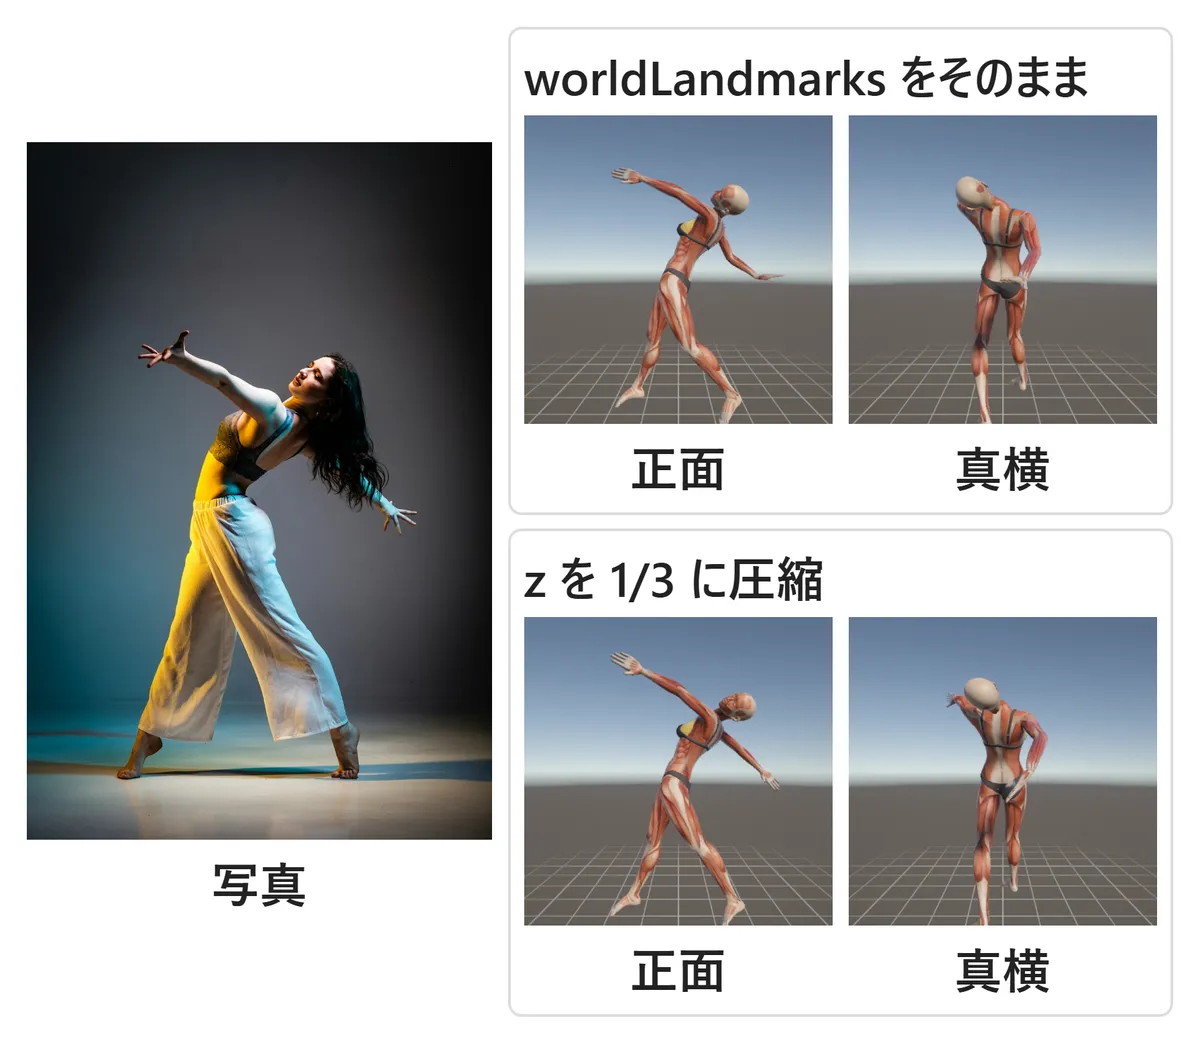
写真では、画面右下へ伸ばした腕がまっすぐです。worldLandmarks をそのまま3Dモデルに使うと、この腕が肘で曲がり、手が腰の近くまで下がりました(右上)。
ずれの元は奥行き z です。PoseMirror で写真から作ったポーズ20件を調べたところ、肘の角度は写真の見た目より平均 +34.1° ずれ、20件すべてで15°以上ずれていました。x と y は画像上の位置そのものですが、z は1枚の写真から推し量るしかないので、誤差が大きくなるのだと考えています。
そこで、landmarks の x と y をピクセル単位に戻し、z だけを 1/3 に縮めてから3Dモデルに渡すようにしました。同じ20件で、肘のずれは平均 +10.3° まで減りました(右下)。1/3 という値は、VTuber 向けのモーションキャプチャアプリ XR Animator の既定値(pose_model_z_depth_scale = 3)にそろえています。
// 画像座標(px)に戻し、z だけ 1/3 に縮める(z は x と同じ尺度なので幅を掛ける)
const px = lm.map(p => [p.x * imgW, p.y * imgH, (p.z * imgW) / 3]);
ずれる向きは写真によって違います。今回の120枚では、伸ばした腕が曲がる例(図の写真)もあれば、曲げた腕が伸びる例もありました。縮める比率は、自分の用途の写真で測って決めてください。
5. 人物が見つからない写真も、範囲を渡せば半分は取れた
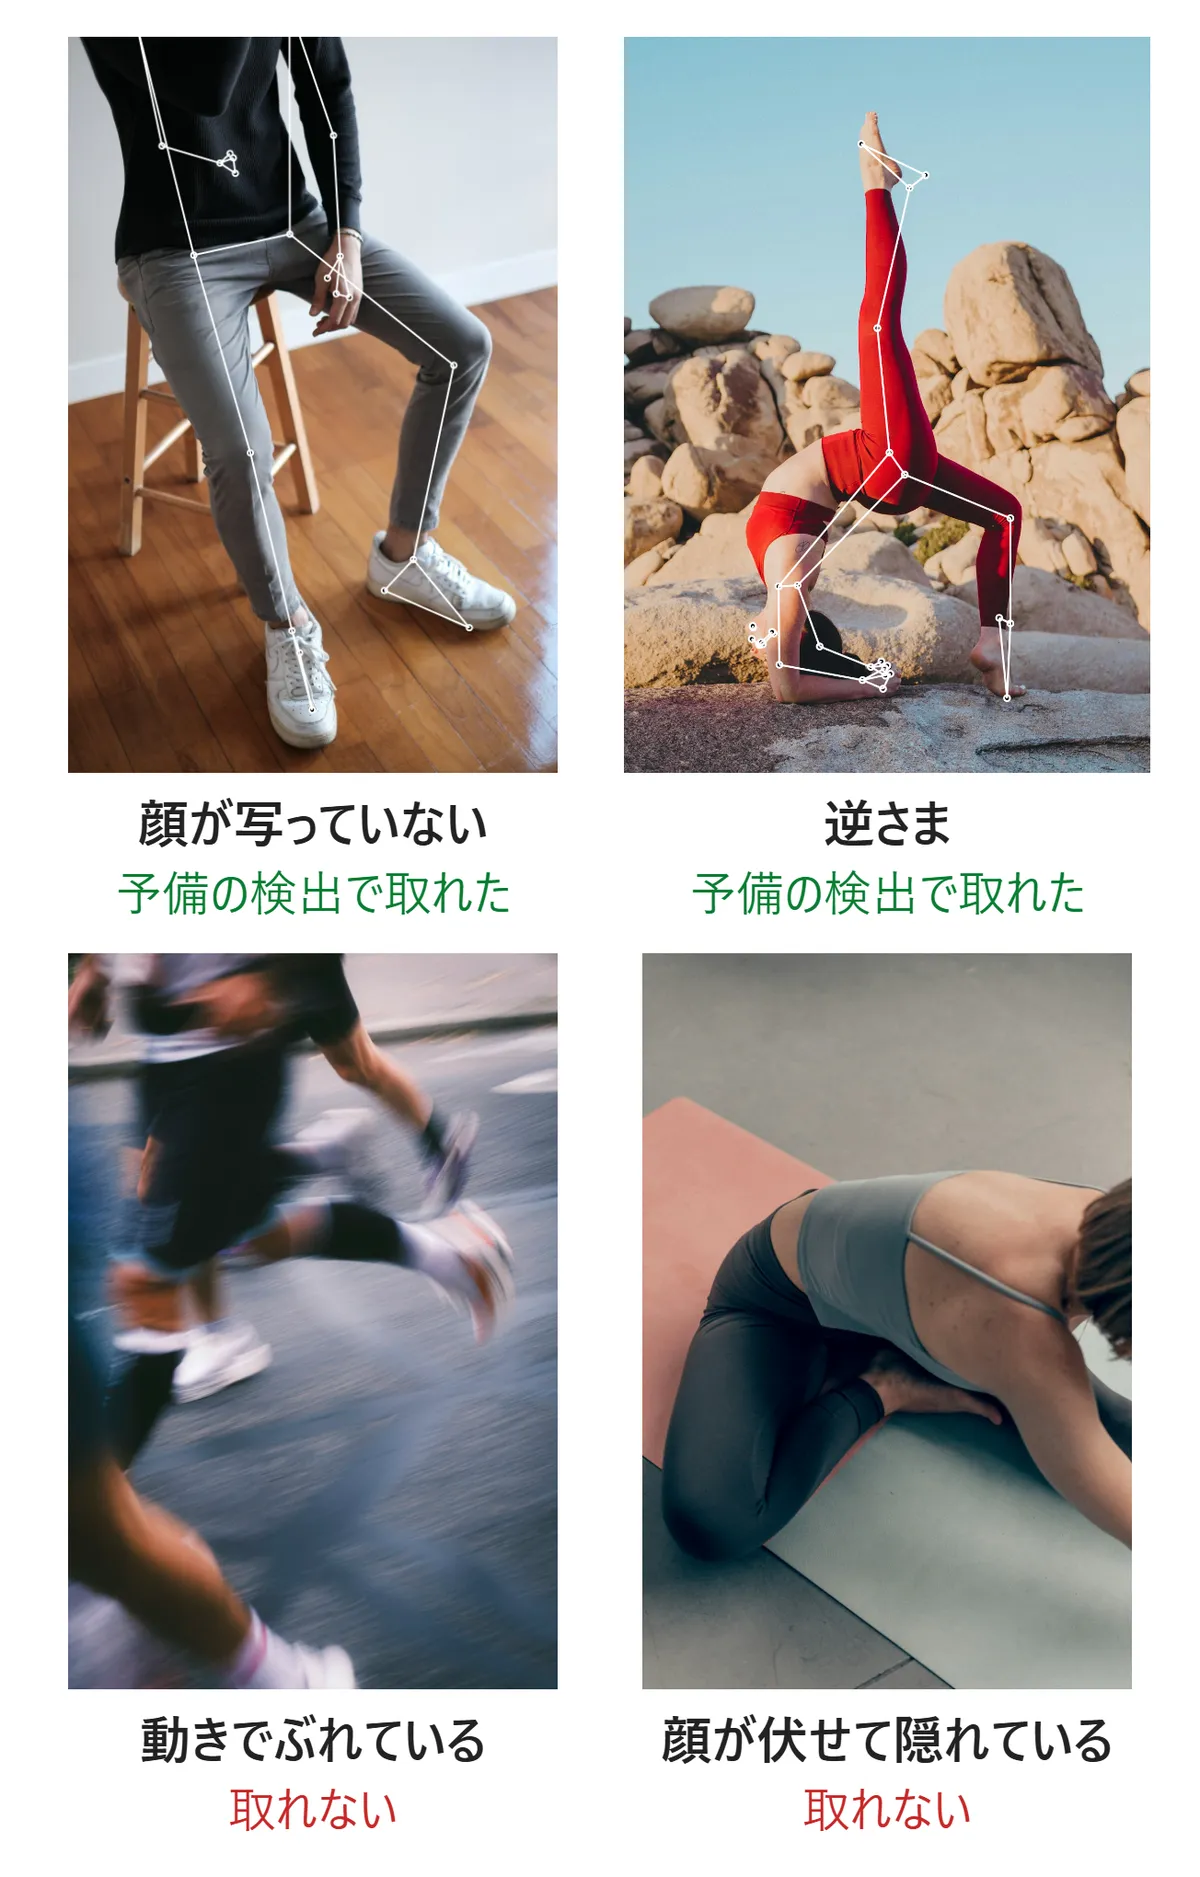
120枚のうち28枚は、どのモデルでも人物が見つかりませんでした。並べてみると、首から下だけの写真、逆さまのポーズ、画面の中で小さく写った人物、動きでぶれた写真が目立ちます。
人物がはっきり写っていても検出されないのは、前段の人物検出器で落ちているためです。後段の骨格推定モデルは、範囲さえ渡せば骨格を返します。そこで、MediaPipe が人物を見つけられなかったときは、Google の別のモデル MoveNet(17点)で体の位置を取ることにしました。その範囲を MediaPipe の骨格推定モデルに直接渡します。
この予備の検出で、28枚のうち 14枚 が取れました(MediaPipe の骨格推定で取れたもの9枚、MoveNet の17点で代用したもの5枚)。図の左2枚がその例です。ぶれた写真や、顔を伏せてマットに伏せている写真は、予備の検出でも取れませんでした。
6. 隠れた関節も座標は返るが、visibility が下がる
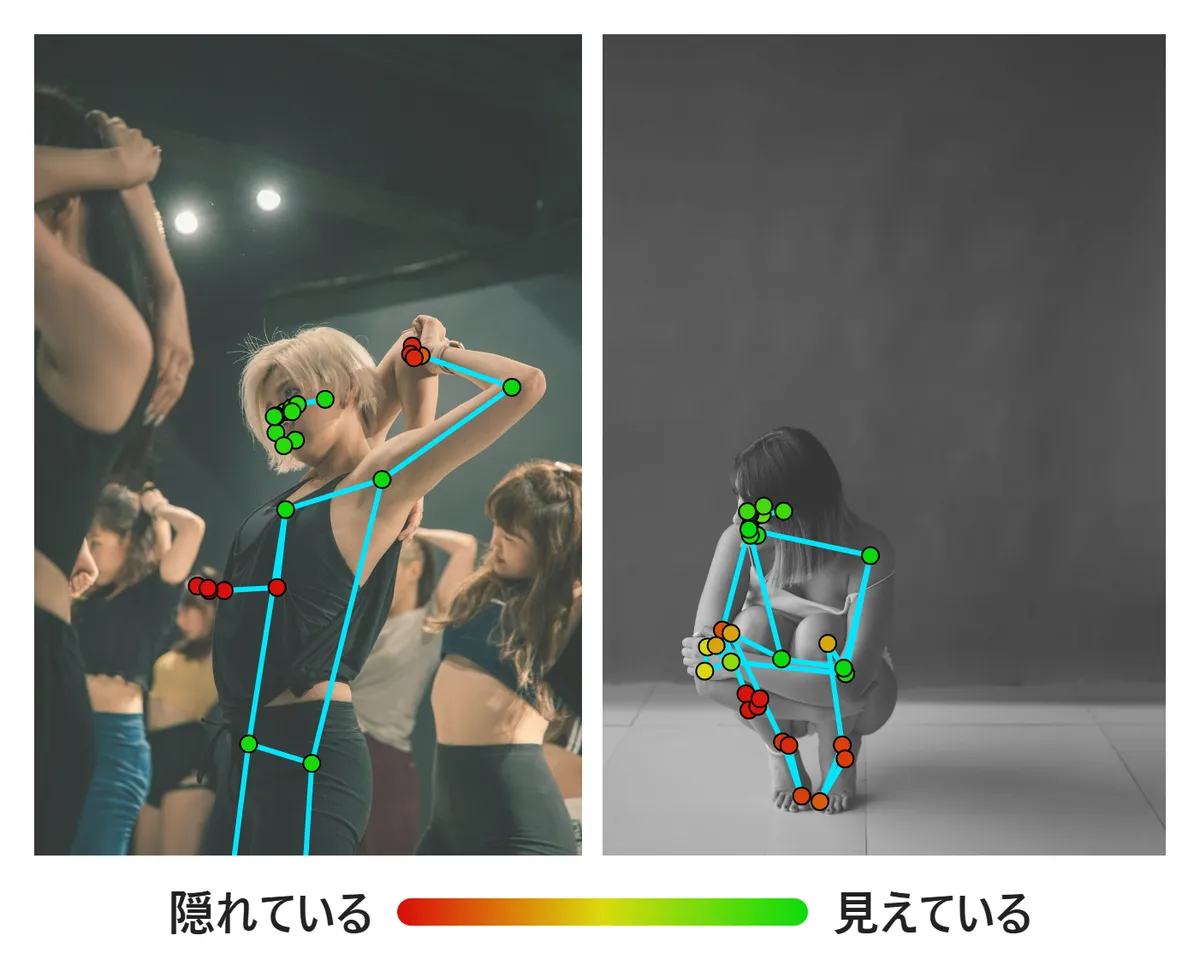
visibility が出力される版(0.10.11 以降)で、関節ごとの値を色にしました。緑が見えている関節、赤が隠れている関節です。
左のダンサーは、頭の後ろに回した手首と、体の陰になった反対側の腕が赤くなっています。右のしゃがんだ人は、膝の陰に隠れた足首とかかとが赤です。隠れた関節にも座標は返ってきますが、位置は推測です。隠れた関節の座標をそのまま使うか、使わずに補うかは、visibility を見て決めます。
PoseMirror で使っている点
PoseMirror の3Dモデルは、33点のうち23点を使っています。
| 用途 | 使う点 |
|---|---|
| 頭の向き | 0(鼻), 7, 8(両耳) |
| 腕 | 11〜16(肩・肘・手首) |
| 手の向き | 17〜20(小指・人差し指の付け根) |
| 胴体・脚 | 23〜28(腰・膝・足首) |
| 足の向き | 29〜32(かかと・つま先) |
目(1〜6)と口(9, 10)は、鼻と耳で頭の向きが決まるため使っていません。親指(21, 22)も、手の向きは小指と人差し指の2点で決まるので使っていません。
まとめ
番号の一覧は公式の図と表で足ります。実装で時間を取られるのは、その外側の挙動です。新しく組むときは、次の順に確かめると手戻りが少なくなります。
まず @mediapipe/tasks-vision の版を見ます。0.10.10 以前だと visibility が出ないので、判定のコードが黙って空振りします。次に delegate を決め、手元の確認も同じ設定で行います。CPU と GPU では検出できる写真が変わるからです。3Dモデルに載せるなら、worldLandmarks の奥行きをそのまま使わず、写真と見比べて z の縮め方を決めます。人物が見つからない写真が多いなら、別のモデルで範囲を渡す予備の検出を足すと、半分ほどは取れるようになります。
この記事の処理は、PoseMirror に写真を1枚ドロップすると試せます。
関連記事:
- 【Unity WebGL】MediaPipeで3Dポーズを動かす:Unity連携の実装全体
- 【検証】PoseMirrorのAIポーズ解析精度を試した:実際の検出精度レポート
- 3Dモデルを動かせる無料サイト・デッサン人形アプリ比較8選:この技術で作ったPoseMirrorと他ツールの比較
参考資料
- Pose landmark detection guide(MediaPipe 公式)
- Pose landmark detection guide for Web(MediaPipe 公式)
- MediaPipe Pose(旧ドキュメント・精度と処理時間の表)
- XR Animator
写真: Unsplash より。Mathilde Langevin、Matea Brajdić、Morgan Petroski、syahmi syahir、Wesley Tingey、Pierre-Antoine FRANCK、Alina Rubo、Chris Yang、SHAYAN Rostami